
À comprendre/Actu & décryptage
Mistral Large 4 : 1 000 milliards de paramètres, en préversion
Mistral ouvre la préversion de Mistral Large 4, son plus grand modèle, sur son API à 1,36 $ le million de tokens. Les poids ouverts sont promis pour fin octobre.
L’essentiel
- Mistral lance le 6 octobre la préversion de Mistral Large 4, son plus grand modèle : 1 000 milliards de paramètres, dont 52 milliards actifs.
- Il lit texte et images, vise le code et le travail de bureau, et Mistral met en avant la cybersécurité, où, sur un test, il devance des modèles fermés qui refusent la tâche.
- Accessible pour l’instant via l’API sur Mistral Studio (1,36 $ le million de tokens en entrée), avec des poids ouverts promis d’ici la fin octobre.
Ce que Mistral lance, et pour qui
Mardi 6 octobre 2026, Mistral a ouvert une préversion publique de Mistral Large 4, surnommé « le Chonk ». C’est le plus grand modèle de l’entreprise française à ce jour : 1 000 milliards de paramètres, dont 52 milliards actifs à chaque calcul. Il comprend le texte et les images, et a été entraîné sur plus de 160 langues, dont toutes les langues officielles de l’Union européenne.
Tu es concerné si ton équipe passe par une API pour brancher une IA dans ses outils. Pour l’instant, le modèle s’essaie uniquement en préversion sur Mistral Studio. L’annonce ne parle pas du Chat.
Sa fiche technique indique une mémoire de travail (contexte) d’un million de tokens. Via l’API, il ne propose que deux niveaux de raisonnement, « none » et « high », note le développeur Simon Willison.
Les poids, c’est-à-dire le modèle téléchargeable, doivent suivre « d’ici la fin du mois », écrit Mistral. L’AFP avance la date du 27 octobre.
La cybersécurité, premier argument de Mistral
Sur l’un des tests de l’indice cyber d’Artificial Analysis, qui demande de reproduire une vraie faille dans un logiciel open source puis de la corriger, ML4 obtient 82 %, le meilleur score de tous les modèles selon l’entreprise. Il résout aussi 93 % des 40 exercices de Cybench.
Mistral souligne que Claude Opus 5.5 et GPT-6 Astra obtiennent presque zéro sur ce test de reproduction de faille, parce qu’ils refusent la tâche. Son argument : les entreprises et les États « ne devraient pas avoir à dépendre d’un fournisseur de modèles fermés susceptible de désactiver arbitrairement leurs capacités de cyberdéfense », dit le communiqué cité par l’AFP.
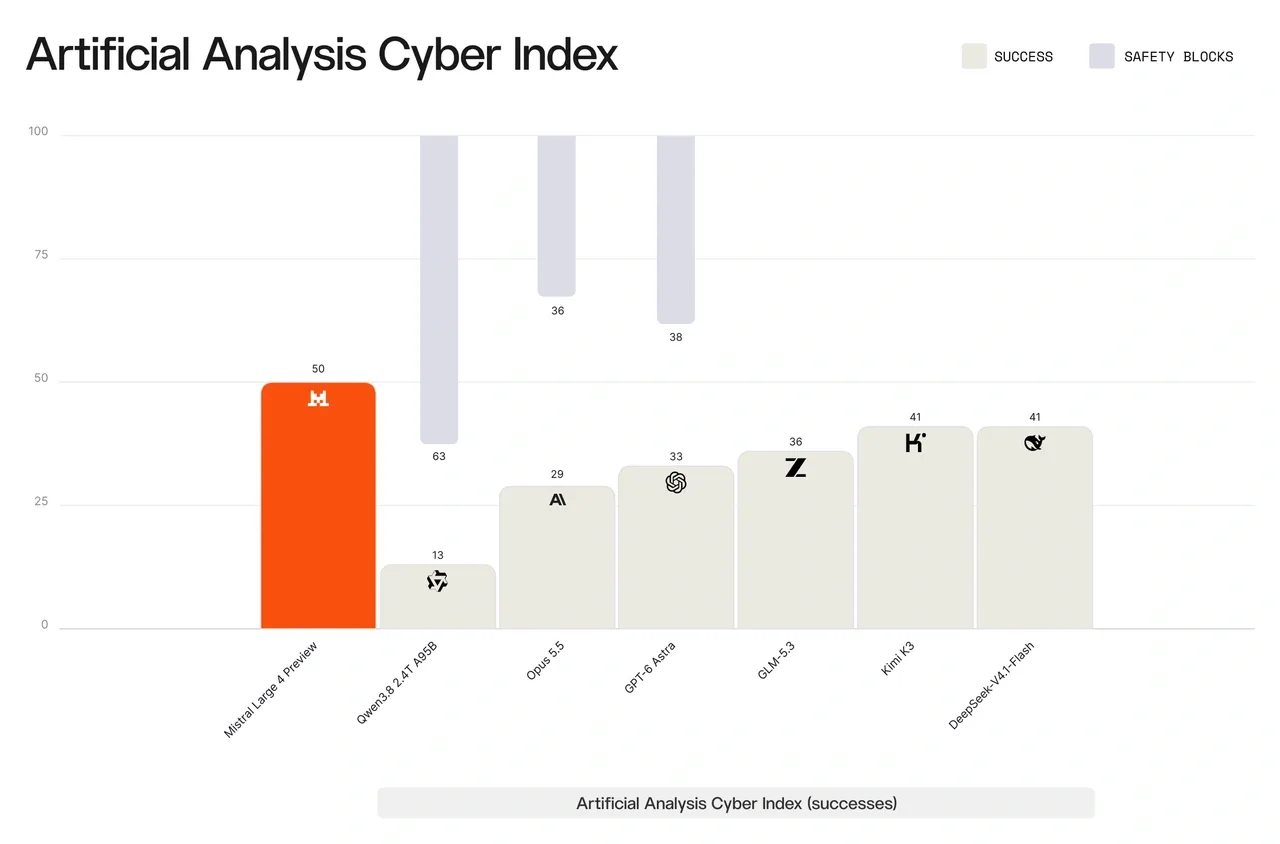
Avant la sortie des poids, Mistral prévoit de faire tester le modèle par des spécialistes de la cybersécurité, des partenaires vérifiés et des autorités publiques, qui y auront accès avec une modération réduite.
Prudence : une faille trouvée n’est pas encore une faille corrigée.
Face aux concurrents : des scores surtout maison
Les quatre premiers résultats sont publiés par Mistral, face aux modèles qu’elle a choisis. Le dernier vient d’Artificial Analysis, un site d’évaluation indépendant :
| Test | Mistral Large 4 | En face |
|---|---|---|
| Indice d’agents de code | 49,8 % | Devant DeepSeek V4 Pro et Qwen3.8 Max |
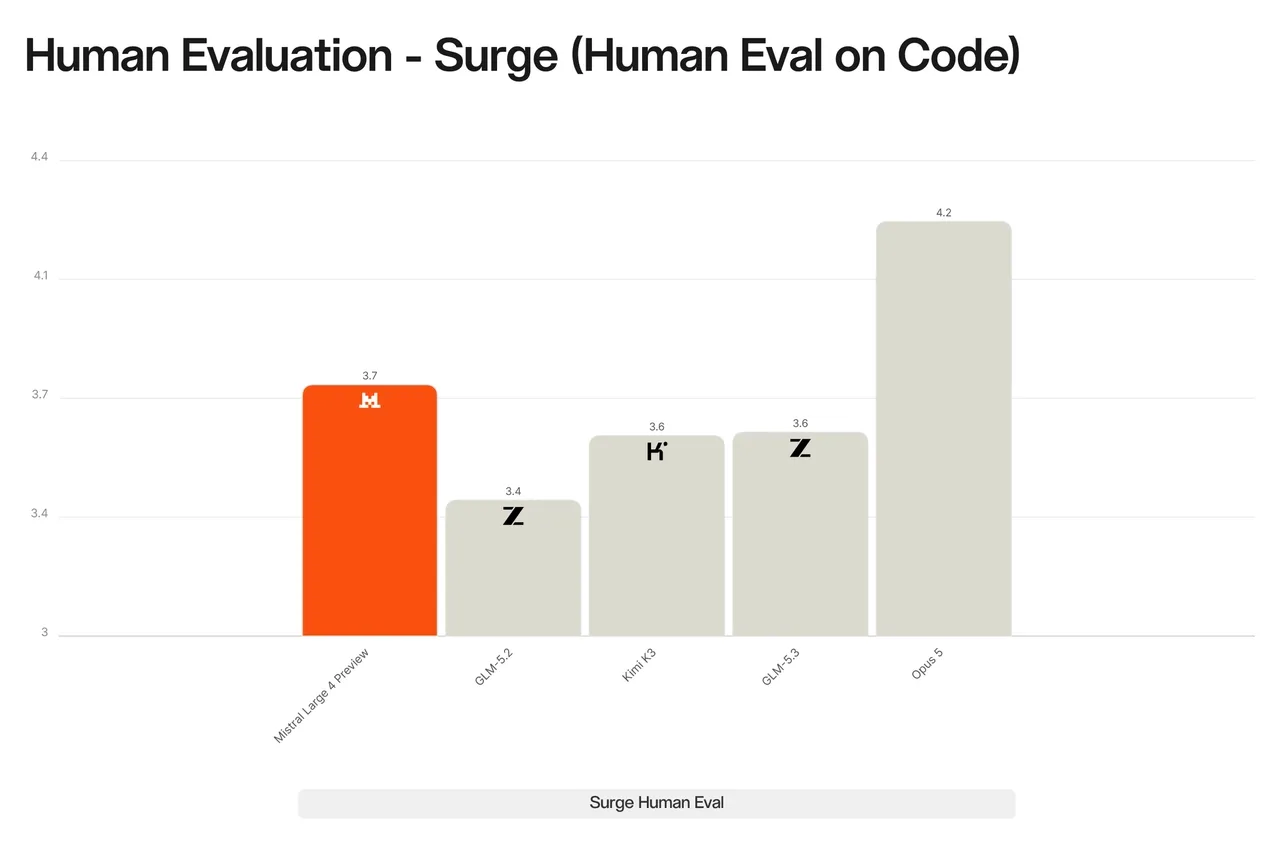
| Qualité du code notée par des humains (sur 5) | 3,74 | Claude Opus 5 : 4,22 ; GLM-5.3 : 3,60 ; Kimi K3 : 3,59 |
| AutomationBench (657 tâches dans Gmail, Sheets, Slack, Salesforce…) | 59,9 % | Devant Kimi K3, MiMo-V2.6-Pro et DeepSeek V4 Pro |
| Repérage d’objets dans des images (Dense 200) | 42 % | GPT-6-Astra : 41 % |
| Indice Artificial Analysis (indépendant) | 38 | Médiane du marché : 26 ; Mistral Large 3 : 9 |
Ce score de 38, contre une médiane de 26, est rapporté par l’AFP. Simon Willison y voit un net progrès sur Mistral Large 3, qui plafonnait à 9. Son verdict : Mistral revient à « peut-être six mois » de la pointe.
Ce que ça change pour toi
Une option européenne qui monte en gamme. ML4 a été entraîné sur 3 800 puces NVIDIA Grace Blackwell, dans les centres de données de Mistral en Europe, et la préversion tourne sur la même infrastructure. Le modèle est aussi proposé dans un déploiement européen que Mistral opère de bout en bout, sous droit européen, indépendamment d’autres fournisseurs.
Des poids ouverts, donc un modèle hébergeable chez soi. Une fois les poids publiés, une entreprise pourra l’installer sur un cloud privé ou ses propres serveurs, et l’utiliser selon ses règles.
Du travail de bureau. Tableurs, présentations, PDF : sur AA-Briefcase, qui mesure ce type de tâches longues, il atteint 1 393 points Elo. En droit et en finance, il dépasse GPT-6-Astra selon l’évaluateur vals.ai, cité par Mistral.
Un prix à comparer. 1,36 $ le million de tokens en entrée et 4,18 $ en sortie. Avant de changer d’outil, choisis selon la tâche, pas selon le classement.
La nuance à garder
Des chiffres maison. Ces scores sont publiés par Mistral, sur des tests qu’elle a choisis, dont certains internes. Elle reconnaît que le modèle doit encore progresser dans plusieurs domaines.
Une préversion qui bouge. L’entraînement par renforcement est « toujours en cours », écrit Mistral : le modèle va encore changer.
Des poids pas encore là. Ni la date exacte ni la licence ne figurent dans l’annonce : pour l’instant, c’est une promesse.
Pas encore au sommet. Claude Opus 5 reste devant sur la qualité du code notée par des humains. Certains écarts sont minces (42 % contre 41 % sur Dense 200). Et le « presque zéro » de Claude Opus 5.5 et GPT-6 Astra sur le test de reproduction de faille mesure des refus, pas une incapacité.
À tester
Un essai sur ta propre tâche avant de te faire un avis.
Si ton équipe a accès à l’API :
- Ouvre Mistral Studio Connecte-toi à la console de Mistral.
- Choisis le modèle Mistral Large 4.
- Compare les deux réglages Lance la même demande en raisonnement « none », puis « high ».
- Mets-le face à ton outil habituel Donne la même demande à l’IA que tu utilises déjà.
Voici un tableau de suivi mensuel [colle tes données]. Résume en cinq points ce qui a changé d’un mois sur l’autre, signale les chiffres qui te paraissent incohérents et propose deux questions à poser à l’équipe. Réponds en français, sans jargon.
Pas de données sensibles tant que ton entreprise n’a pas validé l’outil, et vérifie chaque chiffre.
Sources et lectures complémentaires
Sources vérifiées le 18 octobre 2026. Mis en ligne le 18 octobre 2026.